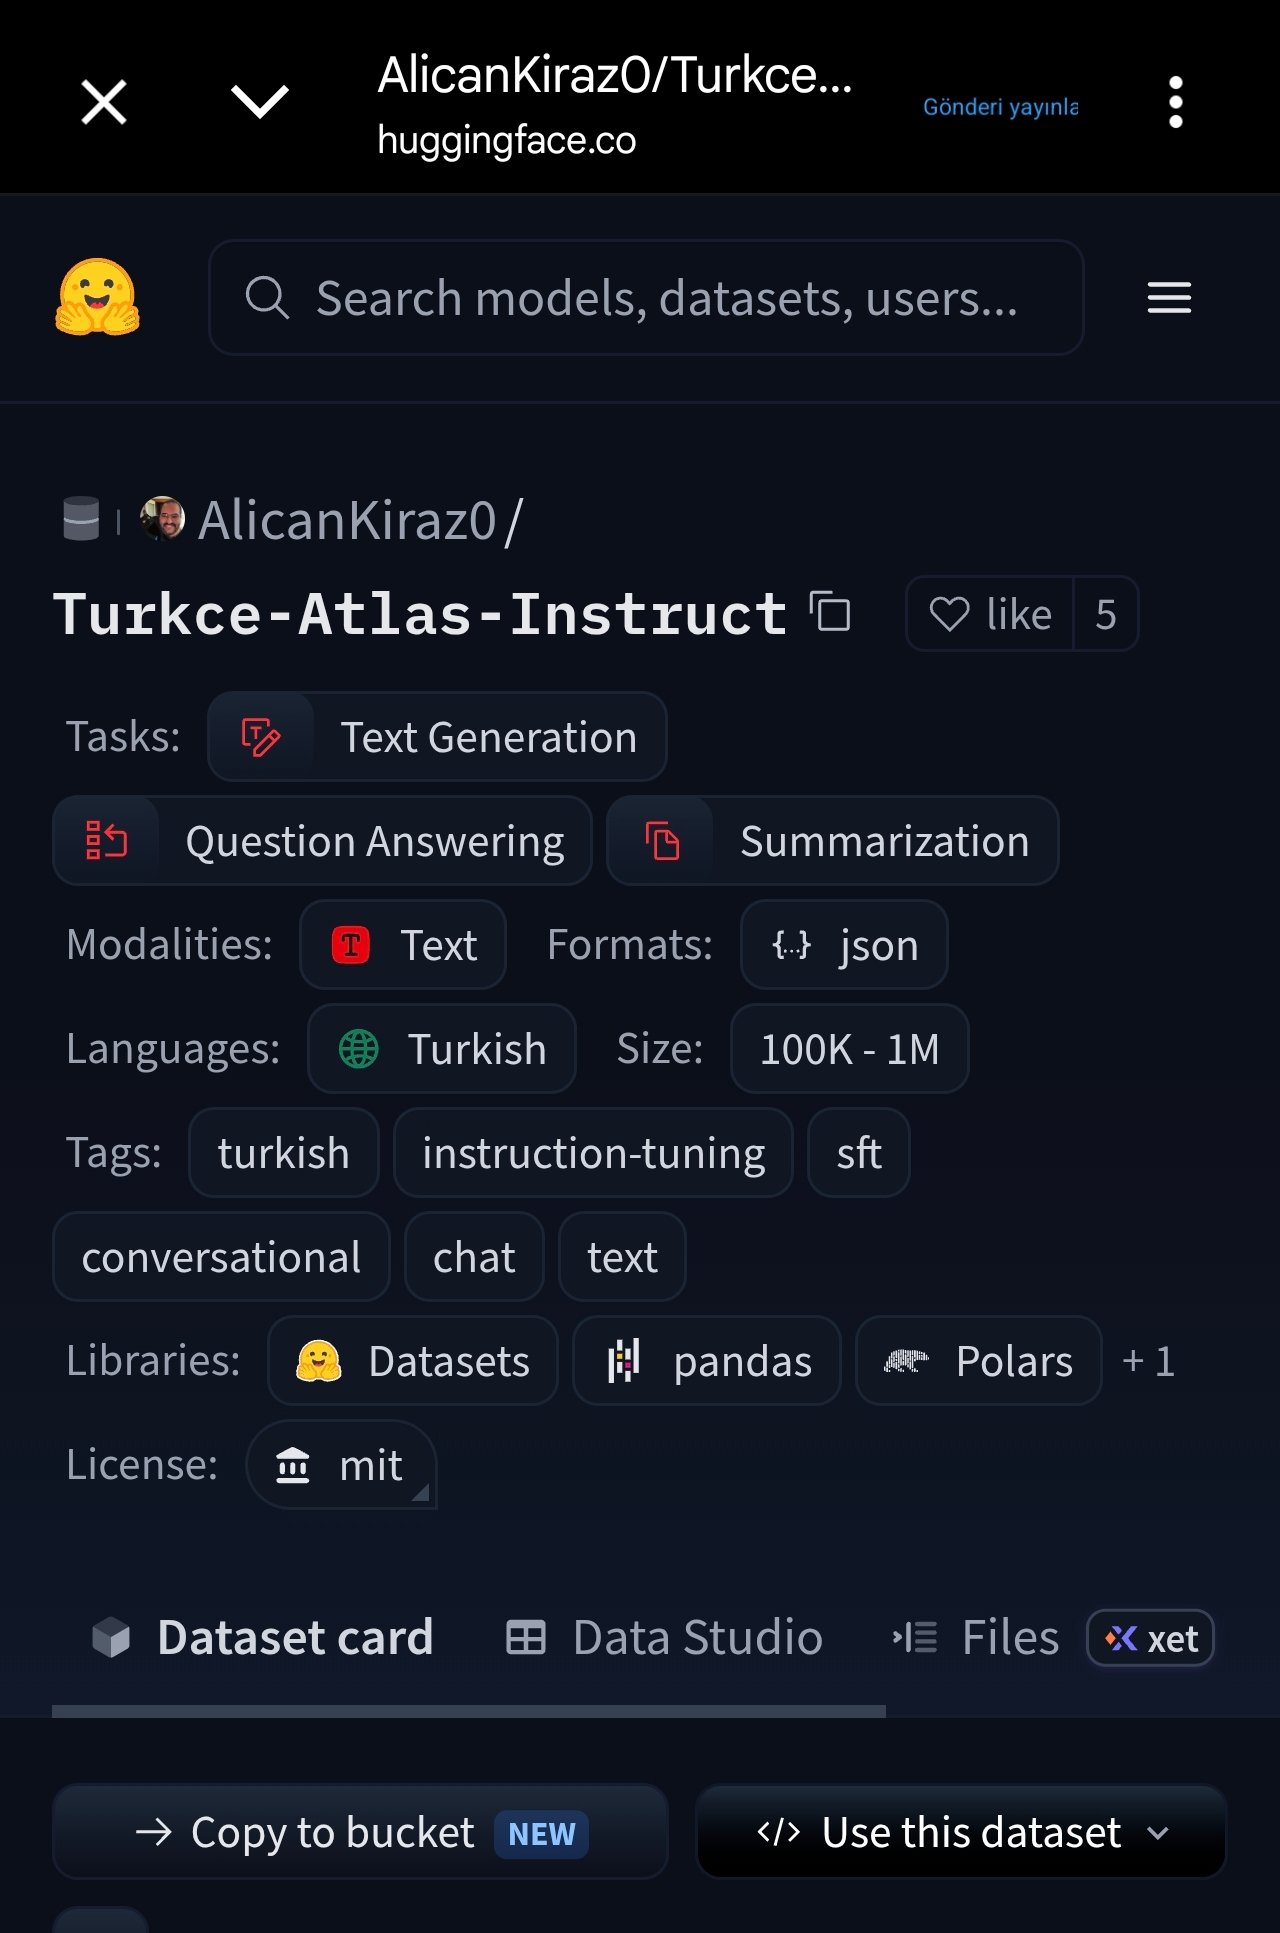
Yerli büyük dil modellerinin önündeki en büyük engellerden biri kaliteli Türkçe öğretim verisiydi. Türkçe Atlas, açık kaynak web verisinden damıtılarak temizlenmiş 336 bin örnekle bu boşluğu doldurmak üzere açık erişime çıktı.
Küme, yapılandırılmış çıktı üretme, özetleme ve komut takibi görevlerini kapsıyor. Hazır SFT süreçleri için sistem–kullanıcı–asistan konuşma yapısı JSONL olarak sunuluyor. Öznel ve kirli içerikten arındırıldığı belirtiliyor.
Türkçe modellerin İngilizce ağırlıklı kümelerle eğitilmesi, hukuk, kamu ve müşteri hizmeti metinlerinde haliyle kırılgan sonuç veriyor. Temiz, görev odaklı bir SFT seti, bu kırılganlığı azaltabilir. 336 bin örnek dev bir ham derlem değil; bilinçli daraltılmış bir öğretim seti.
Açık veri, dışa bağımlılığı azaltır ama tek başına model doğurmaz. Hesaplama, değerlendirme seti ve güvenlik hizalaması hâlâ ayrı iş. Atlas’ın asıl katkısı, yerli ekiplerin aynı kirli web kopyasını tekrar tekrar temizlememesidir.